Meine Frau Sarah ist Traurednerin. Sie schreibt Texte, bei denen Menschen weinen, im guten Sinne. Ich bin ITler. Ich schreibe Systeme, bei denen niemand weinen soll. Und genau zwischen diesen beiden Welten stand jahrelang ein Prozess, der uns beiden auf die Nerven ging. Die Lösung ist am Ende ein Git-basiertes CMS für Nicht-Techniker geworden. Also ausgerechnet Git, das Werkzeug, von dem Sarah bis heute nichts merkt. Und das ist der eigentliche Trick an der Sache.
Aber der Reihe nach.
Das Problem waren nicht die Texte – es waren die Kommas
Sarahs Website lovelywords.eu ist ihre Seite. Ihre Sprache, ihre Persönlichkeit, ihr Ton. Und das ist der Punkt, an dem es früher regelmäßig knirschte: Sie schrieb einen Text, gab ihn mir, ich machte eine SEO-Optimierung drauf, und dann diskutierten wir. Nicht stundenlang, aber über einzelne Worte. Über Satzstellungen. Über ein Komma hier, eine Umstellung da.
Für mich war das völlig irrelevant. Für Sarah überhaupt nicht, weil es ihre Stimme ist, die da rausklingen soll. Und sie hat vollkommen recht damit. Wir hatten also einen kleinen, dauerhaften Interessenskonflikt: Ich wollte einen sauberen, schnellen Durchlauf, sie wollte ihre Formulierung. Und weil ich ihre Texte nicht selbst schreiben will (das ist ihr Job, nicht meiner), blieb ich das Nadelöhr. Jede Änderung lief über mich. Jedes Mal.
Ich habe dafür ehrlich gesagt weder Lust noch Zeit. Wenn ich bei jedem Wortdreher selbst Hand anlegen muss, staut sich das, und am Ende liegt ein fertiger Text tagelang rum, weil ich nicht dazukomme.
Die alte WordPress-Seite hat es nicht gelöst
„Dann gib ihr doch einfach WordPress“ – klar, hatten wir. Die ursprüngliche Seite lief auf WordPress. Theoretisch hätte Sarah dort ihre Texte selbst anpassen können.
Hat sie nie gemacht.
Weil WordPress für ihren Fall schlicht zu viel war: zu langsam, zu groß, zu umständlich. Ein aufgeblähtes Backend mit tausend Optionen, Ladezeiten, Update-Gefrickel. Selbst mit Zugang hat sie es nicht angefasst, und ich konnte es ihr nicht mal verübeln. Wenn ein Werkzeug sich anfühlt wie Arbeit, benutzt man es nicht.
Die Lehre daraus war eindeutig: Was auch immer die neue Lösung wird, sie muss radikal einfach sein. So einfach, dass „ich pass den Text mal eben selbst an“ die naheliegende Option ist und nicht die, vor der man zurückschreckt.
Warum die Inhalte trotzdem Markdown bleiben mussten
Jetzt kommt meine Seite der Geschichte. Die neue lovelywords-Seite läuft auf Astro: schnell, schlank, statisch generiert. Die Blog-Beiträge liegen als Markdown-Dateien in einem Git-Repository, pro Beitrag ein Ordner mit Text und Bildern.
Das hat handfeste Gründe, an denen ich nicht rütteln wollte:
- Versionierung. Jede Änderung ist nachvollziehbar und umkehrbar. Nichts geht verloren, nichts wird versehentlich überschrieben.
- KI-Lesbarkeit. Sauberes Markdown ist das Format, das KI-Systeme und Suchmaschinen problemlos verstehen. Kein HTML-Wust, keine Datenbank-Blackbox, nur Struktur und Text.
- Automatische Bild-Optimierung. Astro macht aus einem reingeworfenen Foto automatisch optimierte WebP/AVIF-Bilder in mehreren Größen. Schnelle Seite, kein Layout-Ruckeln, gutes SEO, ohne dass jemand von Hand etwas konvertiert.
DDer Haken: Genau dieses schöne, saubere Setup ist für einen Nicht-Techniker eine Wand. Markdown-Syntax, Frontmatter, Git-Commits, und iPhone-Fotos kommen auch noch als HEIC daher, ein Format, das im Web niemand direkt anzeigen kann. Von Sarah zu erwarten, dass sie Dateien auscheckt, committet und pusht, ist ungefähr so realistisch, wie wenn sie von mir verlangt, eine freie Trauung zu halten.
Ich brauchte also eine Oberfläche, die all das versteckt, ohne die Vorteile darunter aufzugeben.
Warum ich mich gegen ein CMS mit Datenbank entschieden habe
Die naheliegende Lösung wäre ein klassisches CMS mit Datenbank gewesen. Directus zum Beispiel, auf dem MySQL, das ohnehin schon läuft. Kann viel, moderner Editor, fertige Freigabe-Workflows.
Und trotzdem: nein. Ein Datenbank-CMS hätte mich aus der Git-Welt und aus der Astro-Bild-Pipeline geworfen und mich gezwungen, meine ganzen Markdown-Inhalte in eine Datenbank zu migrieren. Ich hätte den funktionierenden Kern meiner Architektur weggeworfen, um Komfort zu bekommen, den ich auch anders haben kann.
Also habe ich in die andere Richtung gesucht, zu einem Git-basierten CMS. Ein paar Kandidaten sind rausgeflogen (Keystatic kann kein GitLab, Decap wäre der Fallback, aber mit älterer Oberfläche, Eigenbau wollte ich mir nicht antun). Übrig blieb Sveltia CMS: eine schlanke Editor-Oberfläche, die Formularfelder auf Markdown-Frontmatter abbildet und das Ergebnis direkt als Commit in mein GitLab-Repo schreibt.
Das Schöne daran: Der Inhalt bleibt Markdown. Die Migration war praktisch null, weil die Inhalte ja schon im Zielformat lagen. Der Eingriff in meine bestehende Architektur ist minimal-invasiv, und genau das war mir wichtig.
Wie Sveltia CMS eigentlich funktioniert
Weil das der Punkt ist, an dem es für mich klick gemacht hat, hier etwas ausführlicher: Sveltia CMS ist der spirituelle Nachfolger von Netlify CMS bzw. dem heutigen Decap CMS, nur komplett in Svelte neu gebaut, schneller und mit einer Oberfläche, die sich nicht anfühlt wie aus 2016. Die Konfiguration ist dabei weitgehend kompatibel, ich hätte also später auch zurück auf Decap gekonnt. Wollte ich aber nicht.
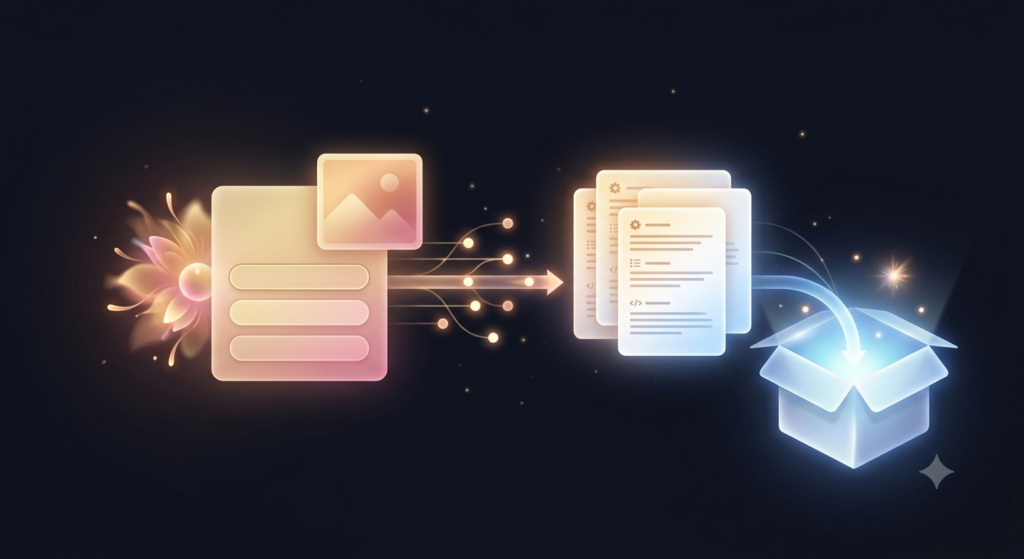
Das Entscheidende ist die Architektur, denn sie ist herrlich unspektakulär: Sveltia ist kein Server und keine Datenbank, sondern eine einzige JavaScript-Datei. Eine Single-Page-App, die komplett im Browser läuft. Ich binde sie per <script>-Tag auf einer kleinen Seite ein, und das CMS liegt einfach unter einer eigenen Adresse neben dem Blog. Es gibt kein Backend, das ich betreiben, updaten oder absichern muss, nichts, was nachts umfällt oder gepatcht werden will.
Was das CMS anzeigt, steuere ich über eine einzige Konfigurationsdatei (config.yml). Darin beschreibe ich sogenannte Collections (für Sarah im Wesentlichen „Blogbeiträge“) und pro Collection die Felder, die sie im Editor sieht. Jedes Feld hat einen Typ, im Sveltia-Sprech ein Widget:
- ein
string-Widget wird zum simplen Titel-Eingabefeld, - ein
markdown-Widget zum Rich-Text-Editor für den eigentlichen Beitrag (mit Fett, Kursiv, Überschriften, ohne dass Sarah ein einziges#oder**sieht), - ein
image-Widget zum Foto-Upload per Drag & Drop, - ein
relation– bzw.select-Widget wird zur Auswahlliste. Genau darüber läuft später meine Orts-Auswahl statt GPS-Koordinaten.
Und hier passiert die eigentliche Magie: Sveltia übersetzt diese Formularfelder eins zu eins in Markdown mit YAML-Frontmatter, und wieder zurück. Was in der Datei als title:, date: oder description: im Frontmatter steht, sind exakt die Felder aus meiner Config; der Rich-Text darunter wird zum Markdown-Body. Sarah füllt ein Formular aus, heraus fällt genau die saubere Datei, die mein Astro-Build erwartet, kein Zwischenformat, keine Übersetzungsschicht, die irgendwann kaputtgeht.
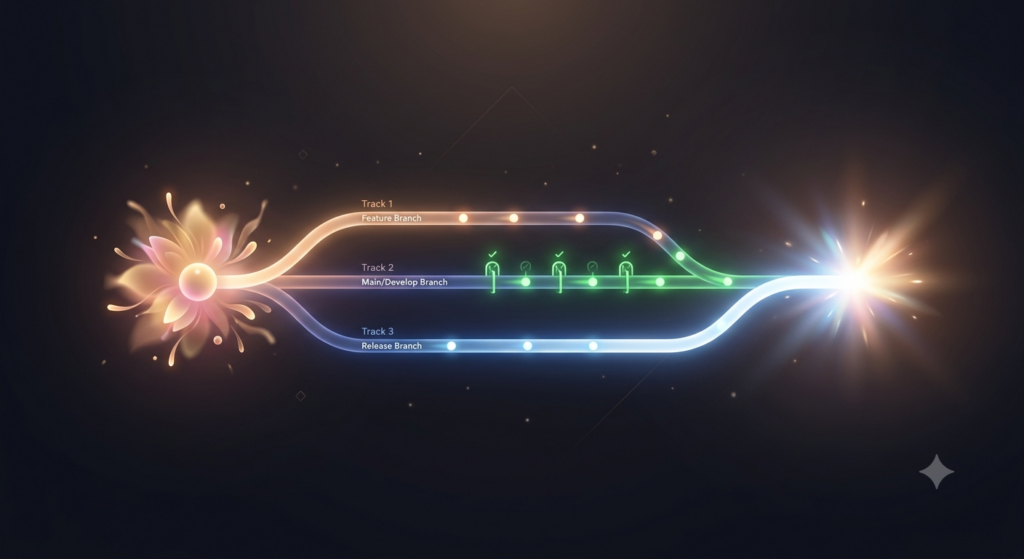
Beim Speichern redet die JavaScript-App direkt mit der GitLab-API und schreibt einen ganz normalen Git-Commit auf den Branch, den ich in der Config festgelegt habe. Das Login läuft über OAuth mit Sarahs GitLab-Account: Sie klickt „Login“, autorisiert kurz bei GitLab und ist drin. Technisch hat sie damit einen echten Git-Zugang mit genau den Rechten, die ich vergebe. Nur nennt es niemand so. Für sie ist es „die Seite, auf der ich meine Beiträge schreibe“.
Kurz: Sveltia ist die dünne, hübsche Fassade vor meinem Git-Repo — es speichert nichts selbst, alles dahinter ist Git, das ich schon hatte.
Der eigentliche Trick: der Git-Flow ist der Freigabeprozess
Jetzt kommt der Teil, auf den ich ein bisschen stolz bin. Sveltia kennt keinen eingebauten Redaktions-Workflow, es arbeitet immer nur auf einem Branch. Statt das als Mangel zu sehen, habe ich es zum Kern des Konzepts gemacht: Der Redaktionsprozess ist einfach der ganz normale Git-Flow, nur ohne dass Sarah das je zu Gesicht bekommt.
Es gibt drei Branches mit klaren Rollen:
| Branch | Wer schreibt | Was passiert |
|---|---|---|
redaktion | Sarah (über das CMS) | Sammelbecken für Inhalte. Ein Speichern hier löst keinen Deploy aus. |
integration | nur ich | Content-Freigabe. Hier laufen automatisch die Tests und der Build. |
main | nur ich | Deploy-Freigabe. Ein Push hier ist der Auslöser für den Live-Gang. |
Abgesichert wird das über Protected Branches in GitLab: Sarah darf ausschließlich nach redaktion schreiben, an integration und main kommt sie strukturell gar nicht ran. Es kann also nichts ungeprüft live gehen. Nicht weil wir uns zusammenreißen, sondern weil das System es nicht zulässt.
Der Merksatz, mit dem ich es Sarah erklärt habe: Du schreibst, ich gebe frei, der Rest passiert von allein.
Warum die Freigabe (noch) über mich läuft – und wohin die Reise geht
An dieser Stelle muss ich ehrlich sein: Dieser manuelle Freigabeschritt ist Absicht, aber nur für jetzt. Ich schaue aktuell bewusst noch einmal drüber, bevor etwas live geht. Nicht, um an Sarahs Formulierungen rumzudoktern (genau das will ich ja loswerden), sondern um harte Probleme abzufangen, bevor sie auf der Seite landen.
Denn ein paar Qualitätskriterien müssen einfach sitzen, bevor ein Beitrag online geht:
- Die SEO-Felder müssen gefüllt sein: Titel, Beschreibung und Co.
- Die Geo-Koordinaten müssen stimmen (dazu gleich mehr), weil falsche GPS-Daten falsches lokales SEO bedeuten.
- Und das Ganze muss thematisch zusammenpassen.
Das Spannende: Diese Prüfungen kann meine GitLab-CI größtenteils schon selbst erzeugen und validieren. Perspektivisch soll der Merge deshalb automatisch durch die Pipeline laufen. Sobald die Qualitäts-Gates grün sind, geht der Beitrag ohne mein Zutun live. Ich bin dann nicht mehr das Nadelöhr, sondern nur noch der, der die Regeln einmal definiert hat. Aktuell will ich einfach noch das Sicherheitsnetz meines eigenen Blicks behalten, bis ich den Automatiken hundertprozentig vertraue. Das ist für einen Blog völlig okay, ein paar Minuten Verzögerung tun niemandem weh.
Was Sarah davon merkt – nämlich fast nichts
Und so sieht Sarahs Alltag heute aus: Sie öffnet die Oberfläche im Browser, loggt sich ein, schreibt ihren Beitrag wie in einem ganz normalen Texteditor, zieht ein Foto rein, tippt einen Alt-Text dazu und klickt auf Speichern. Fertig.
Kein Markdown. Kein Git. Kein Commit. Keine Bildkonvertierung.
Dahinter arbeiten ein paar Automatiken, die früher meine Handarbeit waren:
- Bilder aufbereiten. iPhone-Fotos kommen als HEIC, ein CI-Job konvertiert sie automatisch nach JPEG, schreibt die Referenzen im Text um und setzt die EXIF-Daten (Copyright, Bildbeschreibung aus dem Alt-Text, GPS aus der Location). Sarah muss am Bildformat nichts tun.
- Orte per Auswahl statt Koordinaten. Damit sie keine GPS-Zahlen eintippen muss, gibt es eine zentrale Orts-Liste. Sarah wählt einfach „Weingut XY“ aus, und daraus entstehen automatisch die ganzen Geo-Signale der Seite. Findet sie keinen passenden Ort, lässt sie das Feld leer, den Rest pflege ich später nach.
Ein netter Nebeneffekt der Architektur: Das CMS ist nur aus unserem Heimnetz erreichbar. Keine Cloud, kein öffentlicher Zugang, die Angriffsfläche geht damit gegen null.
Was mich der Weg gekostet hat
Damit hier kein Hochglanz-Bild entsteht: Umsonst gab es das nicht.
- Veröffentlichen ist nicht sofort. Der Weg über die drei Branches und die Pipeline dauert ein paar Minuten. Geschenkt.
- Die Ersteinrichtung war fummelig. OAuth-App, und dann die HTTPS-Geschichte: Sveltia will zwingend eine sichere Verbindung, selbst im Heimnetz. Das über lokal vertrauenswürdige Zertifikate auf allen Geräten hinzubekommen, hat mich ein paar Nerven gekostet.
- Keine echte Vorschau vor dem Merge. Die Vorschau im CMS ist nur ungefähr, wie es final aussieht, sehe ich erst beim Freigeben. Ein Staging-Container wäre möglich, den habe ich mir bewusst für später aufgehoben.
Aber diesen Kompromissen steht der eine große Gewinn gegenüber: Sarah kann endlich selbst bloggen, ich behalte meine saubere, versionierte, KI-lesbare Architektur, und der Streit über die Kommas findet gar nicht mehr statt, weil sie ihre Texte direkt selbst tippt und ändert.
Was ich daraus mitnehme
Die beste Lösung war am Ende nicht die technisch mächtigste. Directus hätte „mehr gekonnt“. Die beste Lösung war die, die niemandem etwas abverlangt, was er nicht will: Sarah muss nichts von Technik verstehen, und ich muss ihre Texte nicht anfassen. Jeder bleibt in seiner Welt, und die Brücke dazwischen läuft von allein.
Das ist übrigens ein Muster, das sich durch fast alle meine Projekte zieht, von der SmileCube Fotobox bis zum Pool: Ich baue am liebsten Dinge, die eine lästige Handarbeit unsichtbar wegautomatisieren. Nicht das größte System gewinnt, sondern das, das man am Ende auch wirklich benutzt.
Und der beste Beweis, dass es funktioniert: Sarah bloggt inzwischen, ohne mich zu fragen. Von Git hat sie noch immer nichts gehört. Genau so soll es sein.
Übrigens: Die Bilder in diesem Beitrag sind natürlich alle mit KI erstellt – der Text aber nicht, den hab ich noch selbst getippt. Passt ja irgendwie zum Thema.

