In Teil 2 ging es darum, warum aus einem Vereinsprojekt ein Produkt wurde. Die Frage, die mir seitdem am häufigsten gestellt wird, ist eine andere: Wie schafft man das nebenbei?
Denn nebenbei war es. Ich habe einen Job, eine Familie und ein Haus, an dem ständig etwas ist. Trotzdem lagen nach wenigen Wochen rund 23.000 Zeilen Produktivcode im Projekt, dazu 94 dokumentierte Entscheidungen und ein halbes Dutzend Konzeptdokumente.
Die ehrliche Antwort: Softwareentwicklung mit KI-Agenten. Und genau das ist der uninteressante Teil der Antwort.
Was wirklich kaputtgeht
Wenn Leute über KI-gestütztes Entwickeln reden, reden sie über Codequalität. Schreibt das Ding brauchbaren Code? Kann es Architektur? Halluziniert es Funktionsnamen?
Meiner Erfahrung nach ist das nicht das Problem. Das Problem ist das Gedächtnis.
Ein Agent hat kein Projektgedächtnis. Er hat ein Fenster, und was hinten rausfällt, ist weg. In der ersten Woche macht das nichts, da passt das ganze Projekt hinein. In der vierten Woche stellst du fest, dass dir jemand eine Entscheidung aus Woche zwei stillschweigend rückgängig gemacht hat. Nicht aus Bosheit. Er wusste einfach nicht mehr, dass sie existierte.
Und du weißt es auch nicht mehr, wenn du es nirgends aufgeschrieben hast.
Deshalb bestand meine Arbeit an diesem Projekt zu einem erheblichen Teil nicht aus Bauen, sondern aus dem Bau einer Umgebung, in der Vergessen nicht möglich ist. Fünf Leitplanken sind daraus geworden.
Erstens: Der Wissensspeicher gehört ins Projekt, nicht ins Werkzeug
Die meisten KI-Werkzeuge legen ihr Projektwissen irgendwo im Benutzerverzeichnis ab. Das ist bequem und falsch.
Bei mir liegt es im Repository. Ein Ordner memory/ mit inzwischen 53 Dateien, dazu konzept/ mit den Anforderungen, dem Datenmodell und der Spezifikation. Die oberste Regel im Projekt steht in Großbuchstaben in der Leitplanken-Datei: Alles bleibt in diesem Verzeichnis. Nichts ins Home-Verzeichnis, nichts nach /tmp, nichts in den globalen Werkzeugpfad.
Der ursprüngliche Grund war banal. Ich arbeite mit meinem eigenen GIT und wollte das Projekt mitnehmen können. Notfalls auch mal an einen anderen Rechner.
Der eigentliche Gewinn ist ein anderer, und der ist mir erst später aufgefallen: Das Projektwissen überlebt damit das Werkzeug. Wenn ich morgen den Anbieter wechsle, wandert das gesamte Gedächtnis mit, weil es nie im Anbieter lag. Es liegt in Textdateien, die auch ein Mensch lesen kann. Das ist keine KI-Anwendung, das ist Dokumentation an der richtigen Stelle.
Zweitens: Jede Grundsatzentscheidung bekommt eine Nummer
Im Projekt gibt es eine Datei mit einer durchnummerierten Liste von Entscheidungen. D1 bis D94.
D1: Termine entstehen aus einem wiederkehrenden Trainingsplan, Einzelfälle laufen als Ausnahme. D12: Das Ding heißt nicht nach dem Verein. D17: Test-Driven Development ist verpflichtend. D26: Karten sind vollständig Opt-in, im Frontend wie im Backend.
Diese Nummern stehen nicht nur in der Datei. Sie stehen in Code-Kommentaren, in Testnamen und in Commit-Botschaften. Wenn ich in einem halben Jahr über eine merkwürdig aussehende Stelle stolpere, steht daneben (D26) und ich finde in zwanzig Sekunden heraus, warum sie so aussieht.
Für die Arbeit mit einem Agenten ist das der entscheidende Baustein. Ich muss ihm nicht die Vorgeschichte erzählen. Ich sage „lies D23 bis D26″ und er hat den Stand.
Der Moment, in dem das Gedächtnis selbst zum Problem wurde
Irgendwann bei Eintrag 90 habe ich gefragt, ob wir nicht in Gefahr laufen, Entscheidungen zu übersehen, weil der Kontext zu groß wird.
Ich habe nachgemessen. Die Datei war auf 221 KB gewachsen, Median 2.140 Zeichen je Eintrag, und die zehn längsten machten allein 28 Prozent aus. Der Entscheidungslog war fast so groß wie sämtliche anderen Konzeptdokumente zusammen. Wer ihn am Stück liest, verbrennt ein Viertel seines Arbeitsspeichers für eine einzige Datei und übersieht trotzdem etwas.
Der naheliegende Reflex wäre gewesen, aufzuräumen. Alte Einträge löschen, ähnliche zusammenlegen, neu durchnummerieren.
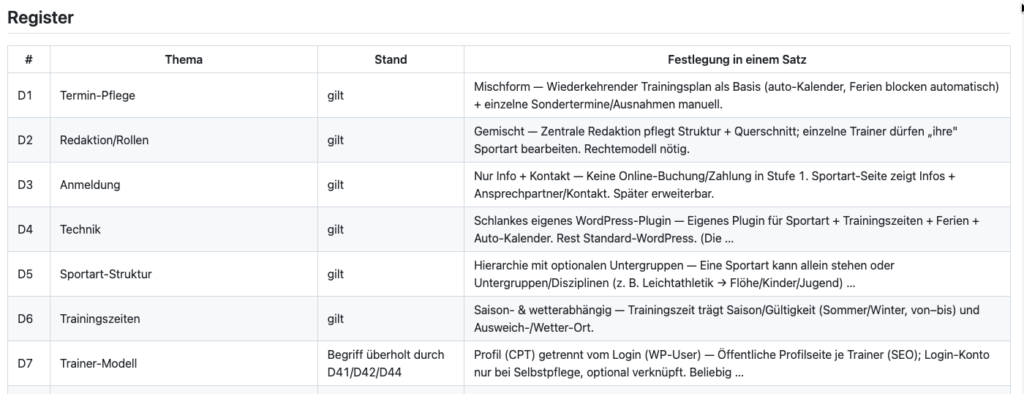
Die Messung hat gezeigt, dass das die falsche Reaktion gewesen wäre. Kein einziger Eintrag war tot, jeder wurde mindestens zweimal referenziert. Das Problem war nie die Anzahl, sondern die Länge. Also wurde nichts gelöscht und nichts umnummeriert, sondern vorne ein Register eingezogen: eine Zeile je Entscheidung, plus ein Wegweiser nach Themen. Zusammen ein Zwanzigstel der Datei und ausreichend für die Frage, um die es fast immer geht: Gibt es dazu schon eine Entscheidung?
Danach waren es 161 KB statt 221, bei gleichem Inhalt. Und die Regel für neue Einträge lautet seitdem: unter 1.500 Zeichen, nur Festlegung, Anlass und Konsequenz. Die Herleitung gehört ins Fachdokument.
Drittens: Ein Test, der die Dokumentation prüft
Das ist der Teil, den ich am wenigsten geplant hatte und inzwischen am wichtigsten finde.
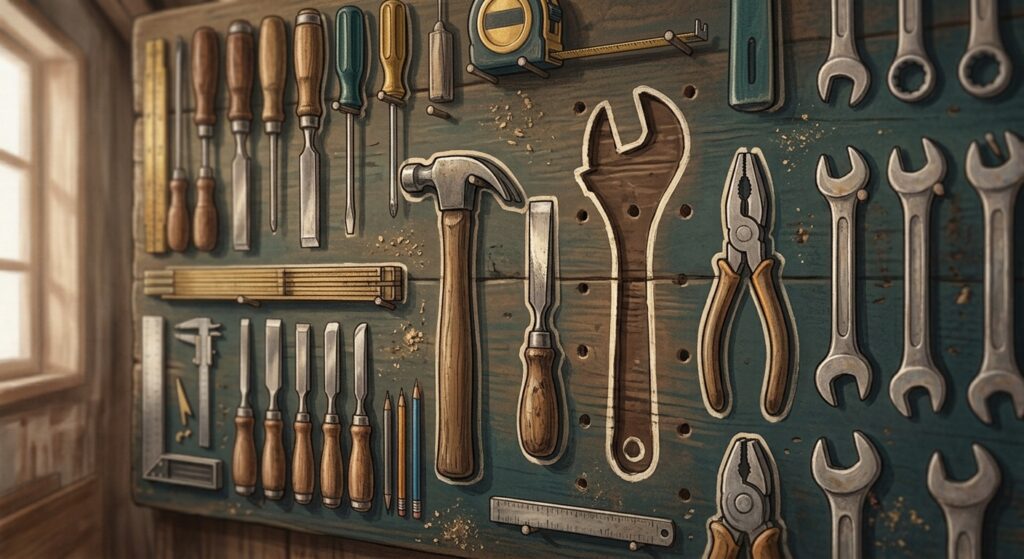
Es gibt im Projekt einen Test, der nichts am Code prüft. Er prüft, ob das Register vollständig ist. Fehlt eine Nummer, wird er rot.
Angefangen hat er als Bequemlichkeit. Ernst wurde es, als ich beim Aufräumen gemerkt habe, dass die Nummer D93 an neun Stellen im Code und in vier Commit-Botschaften stand, die dazugehörige Entscheidung aber nirgends aufgeschrieben war. Irgendwann hatte jemand eine Nummer vergeben und sie nie eingetragen. Mit „jemand“ meine ich uns beide, und ich hätte es ohne den Anlass nie bemerkt.
Seitdem prüft der Test auch die Gegenrichtung: Jede im Repo verwendete Nummer muss einen Eintrag haben.
Dokumentation, die nicht geprüft wird, ist eine Behauptung. Das gilt immer, aber bei KI-gestützter Arbeit wird es akut, weil viel mehr Zeug in viel kürzerer Zeit entsteht und niemand mehr alles gelesen hat.
Viertens: Test zuerst, ohne Ausnahme
Test-Driven Development war ab dem ersten Tag verpflichtend, festgehalten als siebzehnte Entscheidung. Kein Feature ohne Test, jeder Fehler zuerst als Regressionstest, und die Kalenderlogik bewusst framework-frei, damit sie ohne WordPress prüfbar ist.
Das Ergebnis sieht auf dem Papier absurd aus: 24.806 Zeilen Testcode gegen 23.064 Zeilen Produktivcode. Mehr Test als Software, für ein Plugin, das ein Dorfverein bedienen soll.
Mit KI hat das eine zusätzliche Funktion, die in keinem TDD-Buch steht. Ein Test ist die einzige Form von Anforderung, die sich nicht wegdiskutieren lässt. Ein Agent kann meine Absicht missverstehen, meinen Kommentar überlesen oder meine Konvention nicht kennen. Einen roten Test kann er nicht ignorieren.
Die Tests sind damit weniger Qualitätssicherung als Gedächtnis in ausführbarer Form.
Besonders deutlich wird das beim Update-Pfad. Ein Plugin-Update aus dem WordPress-Verzeichnis führt den Aktivierungshaken nicht aus. Alles, was nur dort steht, erreicht bestehende Installationen also nie. Der entsprechende Testlauf holt sich deshalb die zuletzt veröffentlichte Fassung über die Schnittstelle des Verzeichnisses, inklusive echtem ZIP, legt damit einen Datenbestand an und migriert von dort aus. Nach jedem Release prüft derselbe Lauf von allein den nächsten Sprung.
Eine Kleinigkeit daran gefällt mir besonders: Die Prüfung läuft bewusst ohne das Neuschreiben der URL-Regeln. Mit diesem Schritt wird der Lauf nämlich grün, obwohl im echten Betrieb jede Personenseite auf einen Fehler läuft. Nachgemessen haben wir das, indem wir die Korrektur testweise wieder entfernt haben. Ein Test, der immer grün ist, ist kein Test.
Fünftens: Die Umgebung ist dieselbe wie die Pipeline
Lokal läuft alles in einem Container, und zwar in genau dem Image, das auch die Pipeline benutzt. Auf meinem Rechner ist weder PHP noch Composer installiert.
Der Satz „bei mir lief es doch“ kommt dadurch nicht mehr vor. Das ist keine KI-Erkenntnis, das ist normales Handwerk. Es zählt hier trotzdem dazu, weil ein Agent, der eine Abweichung zwischen lokal und Pipeline umschifft, sehr geduldig sehr viel kaputt machen kann.
Die Regel, die ich am wenigsten erwartet hätte
Und dann gibt es noch eine, die nichts mit Code zu tun hat.
Als die Produktseite und die Beschreibung im Plugin-Verzeichnis fertig waren, habe ich sie gelesen und gedacht: Das klingt nach Chatbot. Nicht falsch, nicht schlecht geschrieben. Nur eben glatt auf diese bestimmte Art.
Also haben wir nachgezählt. In den Seitentexten steckten 30 Gedankenstriche, ein Trikolon, drei Antithesen und 14 Fettungen zur Betonung. Das sind genau die Muster, an denen man KI-Texte erkennt, und sie waren vollzählig da.
Seitdem gibt es dazu eine eigene Regel im Projekt, mit einer Liste der Muster und einer Prüfmethode, die so primitiv ist, dass sie funktioniert: Gedankenstriche im Fließtext zählen. Mehr als etwa fünf, und es stimmt etwas nicht.
Der Grund ist nicht Eitelkeit. Ein Ein-Personen-Produkt lebt davon, dass jemand dem Menschen dahinter vertraut. Eine Produktseite, die nach Maschine klingt, beschädigt genau das.
Was das Ganze nicht ist
Damit kein falscher Eindruck entsteht: Hier hat nicht die KI ein Plugin geschrieben, während ich zugeschaut habe.
Die Anforderungen kommen aus einem Gespräch mit einem Verein. Die Architekturentscheidungen sind meine, und sie stehen mit Begründung in einer Datei, die ich verantworte. Jede der 94 Entscheidungen hat jemand getroffen, der abends dafür geradesteht.
Was die KI beigetragen hat, ist Tempo. Sehr viel Tempo. Und Tempo ohne Leitplanken ist genau das, wonach es klingt.
Fazit
Die Werkzeuge werden alle paar Monate besser, und darüber wird viel geschrieben. Was sich nicht ändert, ist der Engpass: Entscheidungen, die niemand aufgeschrieben hat, sind nach drei Wochen weg, und dann baut jemand sie unwissentlich wieder ab.
Meine Antwort darauf sind fünf ziemlich altmodische Dinge. Wissen liegt im Projekt. Entscheidungen haben Nummern. Dokumentation wird geprüft. Tests kommen zuerst. Die Umgebung ist überall dieselbe.
Nichts davon ist neu, und nichts davon habe ich erfunden. Neu ist nur, wie schnell es sich rächt, wenn man es weglässt.
Im nächsten Teil geht es darum, was passiert, wenn so ein Projekt zum ersten Mal von außen begutachtet wird. Das Review von WordPress.org hatte einiges zu sagen, und bei einem Punkt hatte ich schlicht falsch gedacht.